Architecture de Tock
Ce chapitre présente l'architecture générale d'une plateforme Tock : composants et dépendances, flux, configuration de proxies, etc.
Architecture fonctionnelle
Deux composants majeurs sont disponibles :
- le moteur NLU : Natural Language Understanding (voir Tock Studio)
- le framework conversationnel intégré aux services NLU et à différents connecteurs comme Messenger, WhatsApp, Teams ou Slack (voir manuel développeur et connecteurs).

La plateforme NLU est indépendante de la partie conversationnelle. Il est possible d'utiliser le NLU sans devoir maîtriser la complexité induite par la gestion des conversations. Dans certain cas d'usage importants, comme l'Internet des objets, l'utilisation d'un modèle NLU seule est pertinente.
Architecture technique
Tock est composé de plusieurs composants applicatifs (conteneurs lorsqu'on utilise Docker) et d'une base de donnée MongoDB.
Les descripteurs Docker et Docker Compose fournis (ie. les
Dockerfileetdocker-compose.yml) décrivent l'architecture de Tock.Un exemple complet se trouve dans le fichier
docker-compose-bot-open-data.ymldisponible dans le dépôttock-docker.
Base de données MongoDB
La base Mongo doit être configurée en replica set. C'est obligatoire car Tock utilise la fonctionnalité des Change Streams qui a comme pré-requis l'installation en replica set. Un replica set à un seul nœud suffit pour le développement ; en production, déployez au moins 3 instances pour assurer la haute disponibilité de la base de données.
Composants applicatifs
Voici une description rapide des différents composants applicatifs (et images Docker fournies avec Tock) :
-
Interfaces et outils Tock Studio :
tock/bot_admin: Tock Studio
-
Partie NLU :
tock/build_worker: reconstruit les modèles automatiquement dès que nécessairetock/duckling: analyse les dates et types primitifs en utilisant Ducklingtock/nlp_api: analyse les phrases à partir des modèles construits dans Tock Studio
-
Partie conversationnelle :
tock/bot_api: API pour développer des bots (mode Tock Bot API)tock/kotlin_compiler(facultatif) : compilateur de scripts pour les saisir directement dans l'interface Stories and Answers de Tock Studio
-
Partie Gen AI (facultative, voir Gen AI) :
tock/gen-ai-orchestrator-server: orchestrateur Gen AI, appelé parbot_apietbot_adminpour le RAG, la génération de phrases et le playgroundtock/llm-indexing-tools: outils pour indexer des documents dans la base vectorielle, exécutés à la demande- Une base vectorielle : PGVector ou OpenSearch (voir Fournisseurs de bases vectorielles)
- En option, Langfuse pour tracer les appels aux LLM (voir Observabilité)
Un dernier composant, le bot lui-même, doit être ajouté et rendu accessible aux partenaires et canaux externes auxquels on souhaite s'intégrer.
Bien entendu l'implémentation du bot n'est pas fournie avec Tock (chacun implémente ses fonctionnalités propres pour son besoin) mais un exemple est disponible dans
docker-compose-bot-open-data.yml.
Modes de déploiement
- Le mode plateforme NLU seul (sans partie conversationnelle) :

- Le mode Tock Bot API (recommandé pour la plupart des cas), permettant de développer en Kotlin ou un autre langage à travers l'API conversationnelle de Tock :
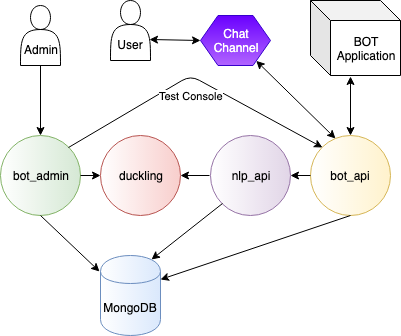
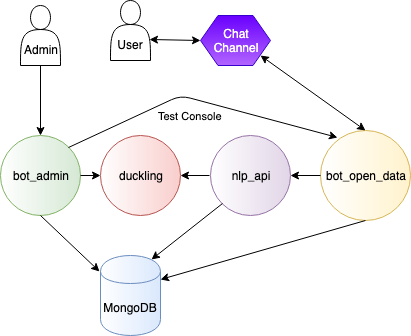
- Le mode Bot intégré (historique) permettant de développer en Kotlin uniquement en utilisant toutes les possibilités de Tock mais en accédant à la base MongoDB directement depuis le bot :
Voir aussi...
 Chat with Tock