Le menu Rag settings
Le menu Gen AI > Rag settings configure le RAG (Retrieval-Augmented Generation) du bot : Tock répond aux questions des utilisateurs avec un LLM, à partir de documents retrouvés dans une base vectorielle.
Pour accéder à cette page, il faut bénéficier du rôle admin (plus de détails sur les rôles dans sécurité).
Fonctionnement
Quand le RAG est activé, il prend en charge les questions qu'aucune story ne traite : phrases que le modèle NLU qualifie d'inconnues, ou dont l'intention n'a pas de story (voir Comment le bot répond) :
- Condensation de la question : un LLM reformule la question pour qu'elle se suffise à elle-même, à partir des derniers messages du dialogue, et en extrait des mots-clés.
- Recherche : les documents les plus proches de la question sont cherchés dans la base vectorielle (voir le type de recherche). Plusieurs variantes de la question peuvent être cherchées, et leurs résultats fusionnés.
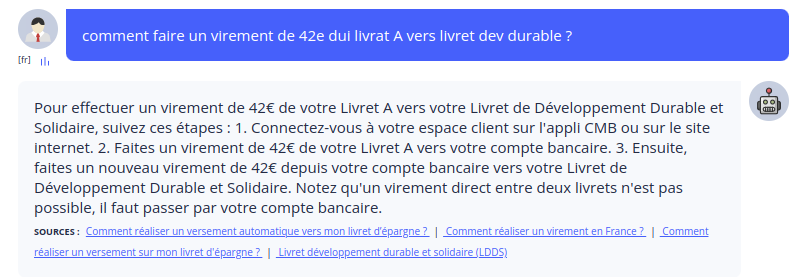
- Réponse : un LLM génère la réponse à partir de la question et des documents retrouvés, en suivant le prompt de réponse. La réponse indique les sources des documents utilisés.
Réglages
Activation du RAG
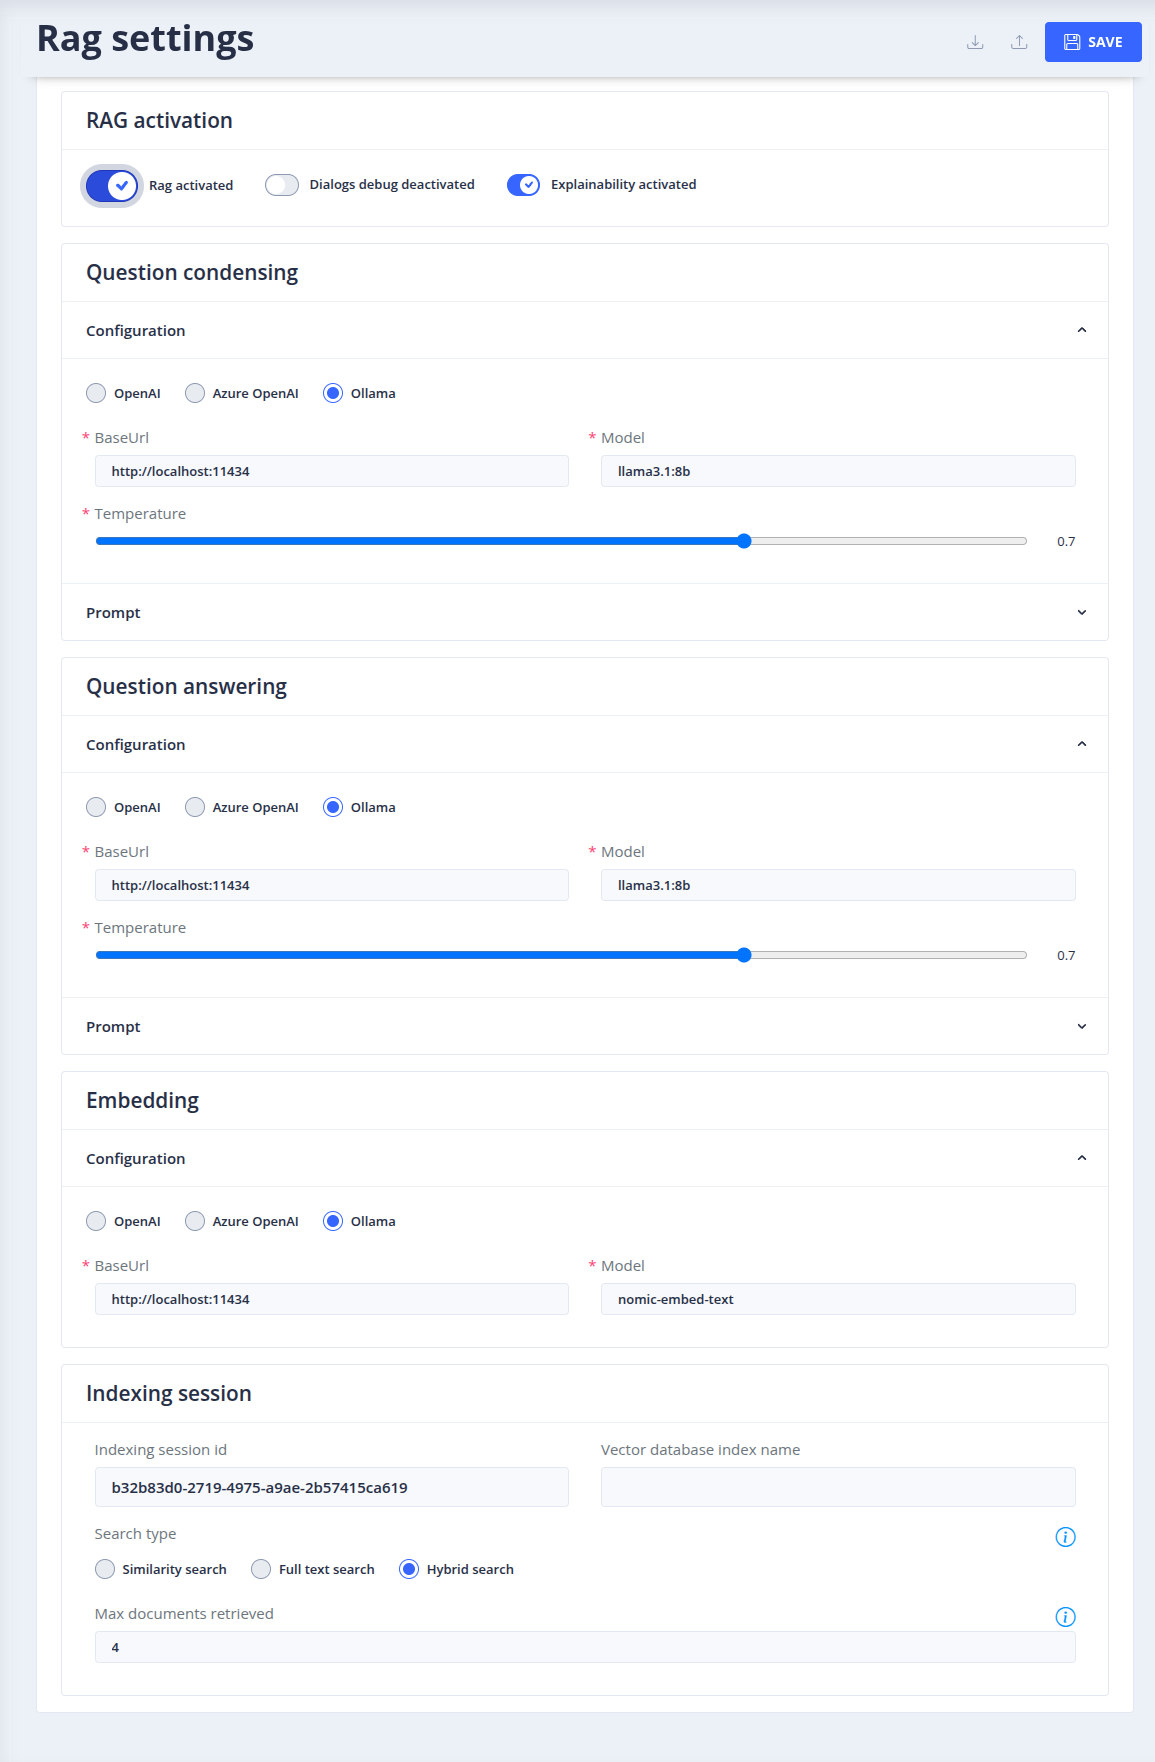
- Rag activated : active ou désactive le RAG pour le bot. Le RAG ne peut être activé qu'une fois tous les champs obligatoires remplis.
- Dialogs debug : inclut les informations de debug du RAG (question condensée, documents, etc.) dans les logs des dialogues (Analytics > Dialogs).
- Explainability : ajoute des instructions d'explicabilité dans le prompt de réponse.
Condensation de la question (Question condensing)
- Configuration : le LLM utilisé pour condenser les questions (voir la liste des fournisseurs de LLM).
- Prompt : le prompt de condensation. Il renvoie aussi les mots-clés (
key_words) utilisés par les recherches plein texte et hybride : un prompt personnalisé doit conserver ce champ pour qu'elles fonctionnent. - Max number of messages in history : nombre de messages du dialogue pris en compte pour condenser la question (zéro : pas d'historique).
Réponse (Question answering)
- Configuration : le LLM utilisé pour générer les réponses (voir la liste des fournisseurs de LLM).
- Prompt : le prompt de réponse. Voir la documentation du prompt RAG. Certains éléments du prompt (thèmes couverts et exclus, lexique métier) se gèrent dans le menu Rag prompt context.
Embeddings
- Configuration : le modèle d'embeddings, qui doit être celui utilisé pour indexer les documents (voir la liste des fournisseurs d'embeddings).
Session d'indexation
- Indexing session id : l'identifiant de la session d'indexation des documents (voir indexation des documents).
- Vector database index name : le nom de l'index dans la base vectorielle, calculé à partir du namespace, du bot et de la session d'indexation (lecture seule).
-
Search type :
- Similarity search : retrouve les chunks par proximité vectorielle (embeddings),
- Full text search : retrouve les chunks par correspondance de mots-clés,
- Hybrid search : combine les deux.
Les recherches plein texte et hybride ne sont disponibles qu'avec PGVector.
-
Max documents retrieved : nombre maximum de documents transmis au LLM comme contexte.
La base vectorielle elle-même se configure dans le menu Vector DB settings.
Export, import et suppression
Les réglages peuvent être exportés (en incluant ou non les données sensibles, comme les clés d'API) puis importés, pour les copier d'un bot ou d'un environnement à l'autre. DELETE SETTINGS supprime les réglages enregistrés.
Import d'une story Unknown quand le RAG est activé
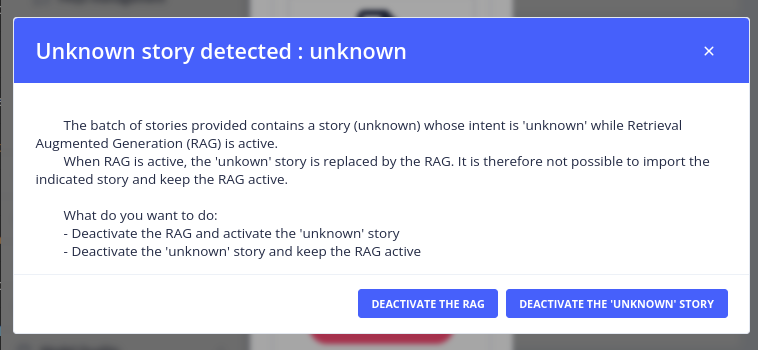
Quand on importe les stories d'un bot vers un autre et que le RAG est activé dans le bot qui les reçoit, un avertissement s'affiche au sujet de la story Unknown (la story qui permet au bot de répondre qu'il ne connaît pas la réponse). Deux options sont possibles :
- désactiver le RAG et permettre l'import de la story Unknown ;
- garder le RAG activé et importer la story Unknown, mais désactivée.
Tester et améliorer les réponses
- Testez le bot dans le menu Test : avec le debug des dialogues activé, les informations de debug du RAG sont disponibles dans Analytics > Dialogs.
- Comprenez pourquoi un document est (ou n'est pas) utilisé avec le diagnostic de recherche.
- Mesurez la qualité des réponses avec les datasets et les évaluations.
- Suivez les appels aux LLM avec un fournisseur d'observabilité.
 Chat with Tock